
La semana pasada se viralizó una frase en X. “Los que ya no revisan el código es porque no saben programar o nunca fueron buenos programando.”
Le respondí. Y me quedé con ganas de decir bastante más, porque en un tuit esto termina siendo un duelo de frases y el tema da para otra cosa.
Arranco por lo que comparto, que es mucho. La responsabilidad no se delega. Si algo se rompe en producción, nadie le va a ir a reclamar al agente. Te vienen a reclamar a vos. Hasta ahí, de acuerdo total.
Lo que no comparto es el salto. Pasar de “hay que revisar” a “si no leés cada línea no sabés programar” es de una simpleza que da miedo. Porque mezcla dos cosas que hace rato dejaron de ser lo mismo… revisar y leer.
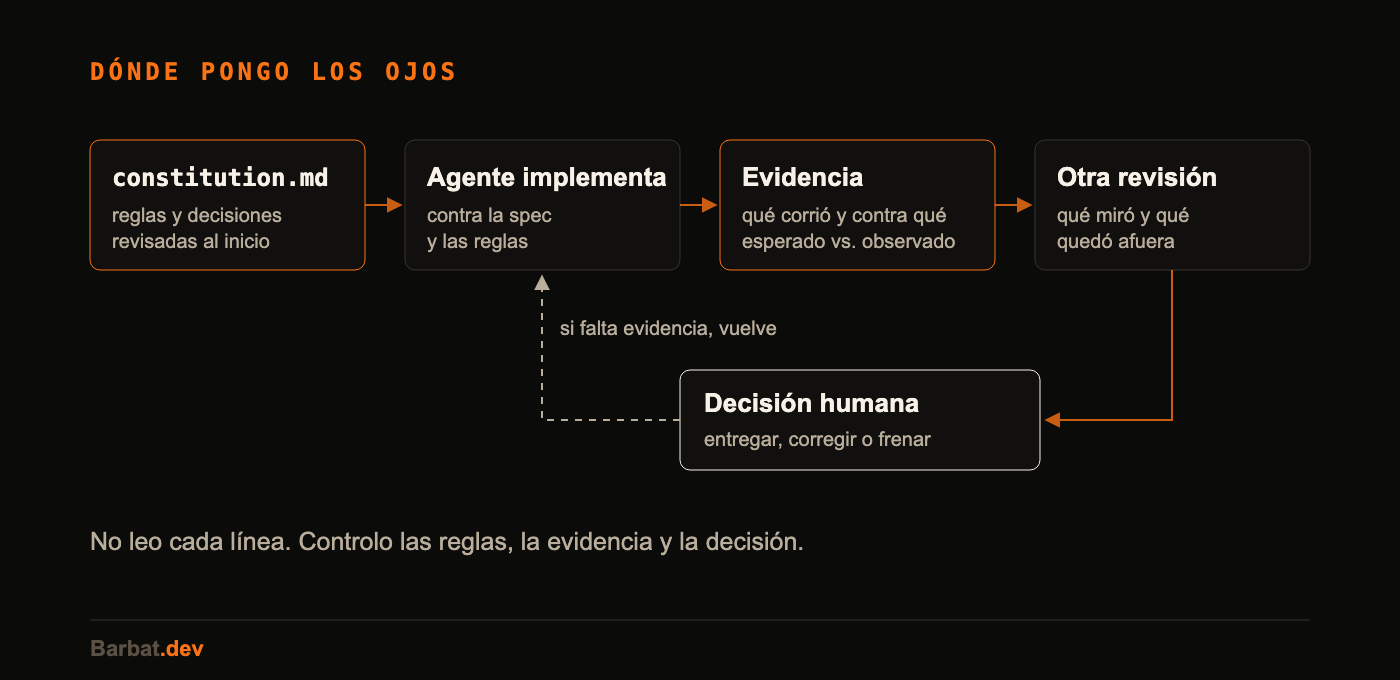
Yo no leo cada línea que escriben los agentes con los que trabajo. Y reviso más que antes.
Siempre trabajamos arriba de cosas que no leemos
Cuando hago una aplicación de gestión no reviso el assembler que sale del compilador. Tampoco me pongo a leer cómo está implementada cada librería, ni bajo a C a ver qué pasa abajo de cada llamada. Y no conozco a nadie en mi rubro que lo haga en el día a día.
Ojo, el bajo nivel sigue importando. Hay gente que vive ahí, y hay bugs que te obligan a bajar. Pero nadie te diría que no sabés programar porque no leíste el código del motor de base de datos antes de tirar un SELECT.
Toda la historia de esta profesión es eso. Ir subiendo de capa, confiar en contratos, en pruebas y en experiencia acumulada… y bajar cuando algo no cierra.
Ahora, hay una diferencia que no quiero esconder abajo de la alfombra. Un modelo no es un compilador. El compilador hace lo mismo siempre. El modelo puede entender mal lo que le pediste, inventarse un supuesto o entregarte algo que parece perfecto y no lo es. Así que no alcanza con decir “es una capa más” y listo. Si vas a trabajar arriba de esa capa, tenés que construir los controles que te dejen hacerlo sin comerte el verso.
Y ahí está la discusión que me interesa. No cuántas líneas dejé de leer, sino qué necesito controlar para poder dejar de leerlas.
Las reglas se escriben una vez y se cumplen siempre
En el mismo hilo Alan (@G_Programming) contó cómo trabaja él. No revisa el código, revisa los fundamentos, los conceptos y los flujos, y pide evidencia. Al principio sí mira a raja tabla que se cumplan la estructura y la arquitectura. Yo le contesté “Yo igual”, porque es exactamente eso.
En nuestros proyectos esas reglas tienen dirección fija. Un constitution.md en cada repo. Se arma cuando el proyecto entra al flujo con agentes… se explora el código, se sacan el stack, las convenciones y las decisiones técnicas, y después lo reviso y lo corrijo yo. Porque lo que el agente infiere no siempre es lo que decidimos, y prefiero enterarme ese día y no tres semanas después.
Ahí queda lo que no se negocia en cada tarea. Stack, convenciones, restricciones de seguridad, cómo se prueba, y cada decisión técnica con su motivo. Cada spec, cada plan y cada implementación arranca de ese documento y se contrasta contra él. No dependo de que el agente se acuerde de algo que le expliqué hace tres sesiones.
La lupa fuerte la pongo ahí, al principio. Después mi laburo es que se respete. Y si aparece una buena razón para cambiar una regla, se cambia a conciencia, en el documento. Lo que no va es que el agente la reescriba de hecho porque le quedaba más cómodo mientras resolvía otra cosa.
Que me muestre, no que me cuente
Pedir evidencia no es pedirle al agente un resumen más largo. Seguro te pasó… el agente termina, te tira un cierre prolijísimo, todo tildado, “implementado y verificado”. Y cuando rascás, la prueba corrió contra otra versión, o no corrió, o probó un caso que no se parece en nada al uso real.
Por eso lo que pido es concreto. Qué se ejecutó, contra qué versión, con qué datos y qué salió. Qué esperábamos ver y qué vimos. Y qué no se pudo comprobar. Un “esto no lo verifiqué” honesto me sirve muchísimo más que un cierre de diez puntos que lo esconde.
Ya conté un caso en Cómo verificamos código generado por IA antes de llevarlo a producción. Tests en verde, fixtures que no se parecían a las respuestas reales, y después la QA funcional encontró un mensaje en pantalla que decía otra cosa de la que estaba pasando. El verde de la suite era parte de la evidencia. No era el permiso para dejar de pensar.
Y ninguna mirada sola alcanza. Los tipos y el análisis estático contestan unas preguntas, los tests otras, y recorrer el flujo como usuario te muestra cosas que no salen en ningún reporte.
Que revise otro agente tampoco es magia
Los agentes también revisan código. Así que cuando digo que yo no leo cada línea, no quiere decir que esa línea no la mire nadie. Parte de delegar es justamente mandar a revisar, con un objetivo claro y un alcance claro.
Pero poner un segundo agente a revisar no te da una garantía. Dos modelos pueden tener el mismo punto ciego, o coincidir porque los dos recibieron el mismo contexto incompleto. Un “aprobado” no me alcanza. Quiero saber qué se revisó, qué apareció y qué quedó afuera. Si falta una prueba importante, vuelve. Y si el riesgo pide meter la nariz en el código, se mete. No me prohibí leer. Dejé de usar la lectura completa como ritual fijo para cada cambio.
Con quién laburo esto
Todo esto lo fui afinando con Gentle-AI™, el harness del ecosistema de Gentleman Programming. Es lo que me deja bajar las decisiones a trabajo concreto… delimitar tareas, delegar, exigir comprobaciones y no perder el control de lo que entra.
Y acá quiero frenar un segundo por Alan. Lo que dijo en ese hilo es lo de menos. Lo veo de cerca, y el mostachudo le pone al proyecto una cantidad de horas que no es normal, comparte todo lo que aprende y no pide nada a cambio. Un monstruo. Con él y con todo el equipo de Gentle-AI™ aprendo un montón, y poder dar una mano como maintainer es un orgullo enorme.
En el día a día, Gentle-Shell™ me deja seguir qué está pasando… los cambios, las tareas, el estado de la sesión. Y Engram™ me guarda las decisiones y los descubrimientos entre una sesión y otra, para no reconstruir toda la historia cada vez que arranco. Ninguno de los dos decide por mí si el producto quedó bien. Son el tablero desde donde manejo.
Los modelos los uso a través de NaN.Builders, el lugar de Borja (@borjaperfra) y Cristian (@barckcode). Soy embajador de NaN, los quiero y banco lo que están armando, así que objetividad absoluta no prometo. Uso real, todos los días, sí. Tener modelos distintos me deja repartir implementación y revisión y buscar otra mirada cuando hace falta. No borra los límites de ningún modelo. Me da opciones, y ver qué aportó cada una sigue siendo laburo mío.
No necesito otro examen de quién sabe programar
Lo que me molesta de la frase no es que defienda la revisión. Es que agarra una práctica y la convierte en un examen de pertenencia. Y no voy a contestar con lo mismo al revés… leer menos código tampoco te hace mejor dev.
Las preguntas que me importan son otras. Podés explicar qué se construyó y por qué se hizo así? Sabés con qué evidencia aceptaste el resultado, y qué quedó sin comprobar? Podés frenar una entrega cuando algo no cierra, aunque el agente te jure que terminó?
Si la respuesta es sí, estás revisando. Leas o no cada línea.
El criterio de negocio sigue siendo mío. Si un cambio le hace la vida más fácil a quien usa el producto o se la complica, eso no lo decide una métrica ni una votación de agentes. No dejé de controlar. Cambié dónde pongo los ojos.
Porque si no tenés reglas, evidencia y alguien que decide, no tenés autonomía. Tenés un quilombo con buena interfaz.
El viernes seguimos
Este viernes seguimos con la app de presupuestos, llevándola de SaaS chico a SaaS grandecito, con las decisiones que van apareciendo al hacerla crecer. Es esta forma de trabajar, en vivo, con lo que salga y con lo que no.
Nos vemos a las 19 hs de Uruguay en el directo de RefactorIA. Y en el Discord de RefactorIA seguimos la charla… me interesa mucho saber cómo lo están resolviendo los que también tienen software real que entregar.